

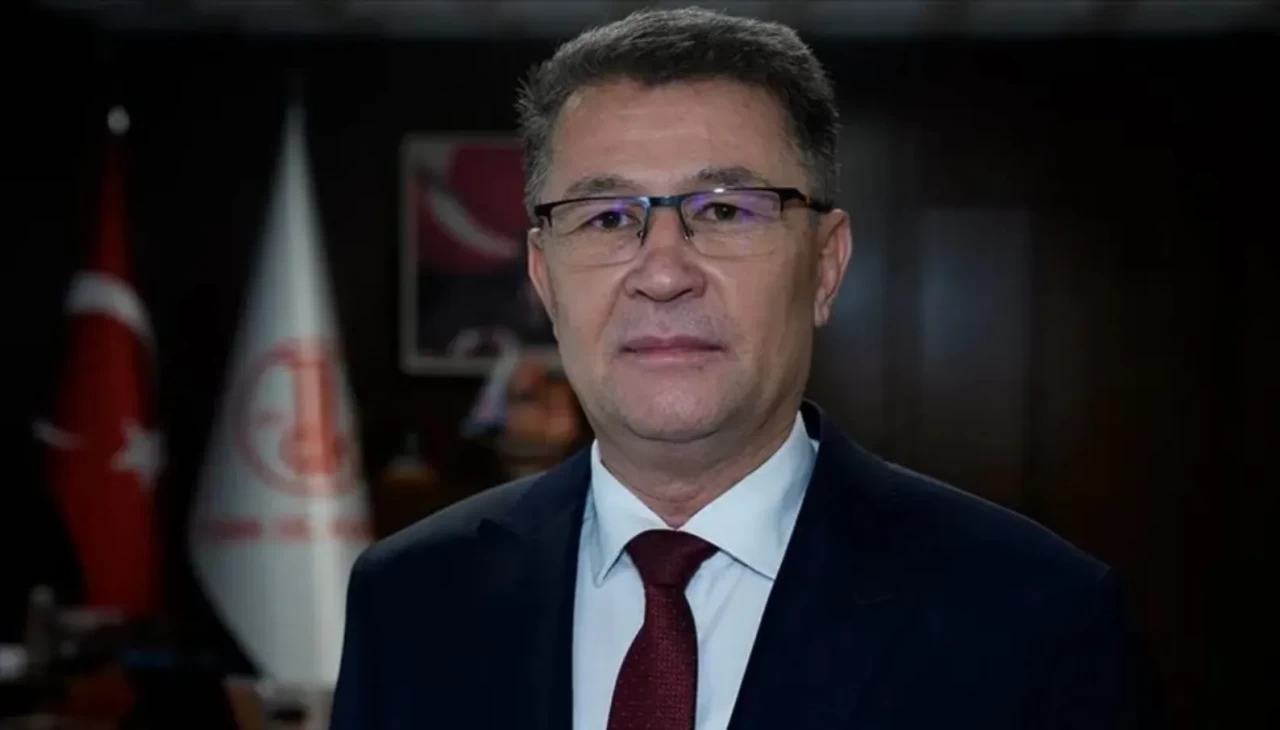


Türk Dil Kurumu (TDK) Başkanı Prof. Dr. Osman Mert, Türkçenin korunması, geliştirilmesi ve gelecek nesillere aktarılması amacıyla yürüttükleri çalışmalara ilişkin bilgi verdi. Mert, 800 bini aşan söz varlığına ulaşması öngörülen yeni bir sözlük üzerinde çalıştıklarını, Türkçe düşünen yapay zekanın eğitilmesi için büyük dil modeli geliştirdiklerini ve dil yanlışlarını tespit edecek yazılımlar hazırladıklarını bildirdi.
TDK’nin yeni sözlüğünde 800 bin kelime hedefleniyor
Mert, Türk Dil Kurumunda 21 kol ve komisyonun çalışmalarını sürdürdüğünü belirterek, gelecek dönemde hayata geçirilmesi planlanan projelerin başında yaşayan Türkçenin sözlüğünün hazırlanmasının geldiğini söyledi.
Mevcut Türkçe Sözlük'ün yaklaşık 132 bin kelime içerdiğine işaret eden Mert, yeni çalışmayla yalnızca edebiyat dilinin değil, farklı bilim dalları ve kültür alanlarında kullanılan Türkçenin de kapsamlı şekilde kayıt altına alınmasının hedeflendiğini belirtti.
Mert, yeni sözlük çalışmasına ilişkin şunları kaydetti:
"Şu an yoğunlaştığımız konulardan birisi yaşayan Türkçenin sözlüğünü hazırlamak. Bu, bütün kültür alanlarını, bütün bilim dallarını temsil eden, Türkçeyi temsil kabiliyeti yüksek bir sözlük olacak. Bizim şu anki sözlüğümüz edebiyat dili sözlüğü. 132 bin civarında kelime var. Ama bizim yaptığımız sözlükte ilk denemelerde gördüğümüz, 800 bini aşan söz varlığına ulaşmayı öngörüyoruz. Böyle bir fark olacak."
Bir milyar kelimelik derlem oluşturuldu
Yeni sözlük çalışmasında bir milyar kelimelik, Türkçeyi temsil kabiliyeti yüksek ve dengeli bir derlem oluşturulduğunu anlatan Mert, bu çalışma sayesinde kelimelerin bağlama göre kazandıkları anlamların yanı sıra atasözleri, deyimler, terimler ve dildeki yapıların farklı işlevlerinin tespit edilebileceğini söyledi.
Mert, çalışmanın Türkçenin söz varlığının daha kapsamlı şekilde ortaya konulmasına katkı sağlayacağını ifade etti.
Türkçe düşünen yapay zeka geliştiriliyor
TDK'nin dijitalleşme ve yapay zeka alanındaki çalışmalarına da değinen Mert, Türkçe düşünen yapay zekanın geliştirilmesi ve eğitilmesi amacıyla büyük dil modeli üzerinde çalıştıklarını belirtti.
Mert, yaklaşık üç yıldır devam eden çalışmanın kuramsal aşamasının tamamlandığını ve fiili aşamaya geçildiğini söyledi. Projenin HAVELSAN ile yürütüldüğünü belirten Mert, teknik altyapının büyük oranda tamamlandığını ve veri girişinin başladığını kaydetti.
Çalışmada verilerin detaylı şekilde etiketlendiğini aktaran Mert, oluşturulacak veri setinin hem Türkçe düşünen yapay zekanın geliştirilmesinde hem de dil araştırmalarında kullanılabileceğini ifade etti.
Türkiye Terim Bankası'nda 310 bin terim yer alıyor
TDK'nin üzerinde çalıştığı projelerden birinin de Türkiye Terim Bankası olduğunu belirten Mert, bu kapsamda önce terim komisyonunun aktif hale getirildiğini, ardından ilgili bakanlıklar, kamu kurumları ve Cumhurbaşkanlığı temsilcilerinin yer aldığı "Kurumlar Arası Terim Eşgüdüm Komisyonunun" oluşturulduğunu anlattı.
Yazılımın ilerleyen süreçte Türk dünyasını da kapsayacak şekilde tasarlandığını belirten Mert, Türkiye Terim Bankası'na şu anda 310 bin terim girildiğini bildirdi.
Mert, projeye ilişkin şöyle konuştu:
"Türk Dünyası Terim Bankası olabilecek şekilde bir yazılım hazırladık. Şu an Türkiye Terim Bankası'na 310 bin terim girilmiş durumda. Onu da inşallah bu yıl açacağız ve halkımızın, ilgili kurumların hizmetine sunacağız. Ardından Türk dünyasından terimler aynı şekilde bu veri bankasına girilmeye başlayacak. Nihayetinde Türk Dünyası Terim Bankası oluşmuş olacak."
Dil yanlışlarını tespit eden yazılımlar hazırlanıyor
Mert, dijital ortamda Türkçenin doğru kullanımını desteklemek amacıyla yeni yazılımlar geliştirdiklerini de açıkladı.
Bu yazılımlardan birinin Türkçe metinlerdeki dil, yazım ve noktalama yanlışlarını tespit ederek doğru kullanım önerileri sunacağı bildirildi.
Kamu kurumlarının internet sitelerindeki dil yanlışlarını tespit etmeye yönelik ayrı bir yazılım üzerinde de çalışıldığını belirten Mert, şunları söyledi:
"Genel ağ sayfalarını 24 saat tarayan ve yazım yanlışlarını, dil yanlışlarını tespit edip bize raporlayan bir yazılım şu an devam ediyor."
Türkçe Sözlük'te yer almayan kelimelerin tespit edilmesine yönelik bir başka yazılımın da hazırlandığını aktaran Mert, sistemin sözlükte bulunan bütün kelimeleri tanıyacağını ve genel ağ ortamını gün boyunca tarayarak sözlükte bulunmayan kelimeleri Kuruma raporlayacağını anlattı.
Mert, söz konusu üç yazılımın bir yıl içinde hizmete sunulmasının planlandığını kaydetti.
Öğretmenlere diksiyon kursları düzenleniyor
Mert, Türkçenin doğru ve etkili kullanımına yönelik eğitim çalışmalarının da sürdüğünü belirtti.
Öğretmenlere yönelik diksiyon kursları düzenlediklerini ifade eden Mert, şöyle konuştu:
"Önce Ankara'da, daha sonra Kıbrıs'ta, Karaman'da ve Denizli'de öğretmenlerimize yönelik diksiyon kursları yaptık. Ardından bunu ülke geneline de yayma düşüncemiz var."
Eğitimlere yönelik olumlu geri bildirimler aldıklarını ve artan talep üzerine çalışmaları daha kurumsal hale getirdiklerini aktaran Mert, diksiyon eğitimlerinin yanı sıra gençlerin yazma becerilerini geliştirmek amacıyla öykü atölyesini de hayata geçirdiklerini söyledi.
Geçen yıl düzenlenen öykü atölyesine Ankara'daki üniversitelerden lisans ve yüksek lisans öğrencilerinin yoğun ilgi gösterdiğini belirten Mert, ekim ayında başlayıp haziranda tamamlanan 120 saatlik programda ortaya çıkan eserlerden bir seçki hazırladıklarını ifade etti.
Seçkinin baskı aşamasında olduğunu belirten Mert, "Amacımız gençlerin özellikle yazma becerisini desteklemek ve toplumda bu konuda bir farkındalık oluşturmak. Bu yıl yine ilana çıktık. Çok fazla müracaat var." diye konuştu.
İnternet ve sosyal medyadaki kullanımlar takip ediliyor
İnternet ve sosyal medyanın yaygınlaşmasıyla özellikle gençlerin konuşma ve yazı dilinde özensiz kullanımların arttığını gözlemlediklerini belirten Mert, Milli Eğitim Bakanlığı ile işbirliği içinde bu konularda farkındalık oluşturmayı hedeflediklerini söyledi.
TDK'nin temel amacının Türkçeyi korumak, geliştirmek ve gelecek nesillere sağlıklı şekilde aktarmak olduğunu ifade eden Mert, akademik çalışmaların yanı sıra toplumun farklı kesimlerine ulaşmayı amaçlayan eğitim programları, atölyeler ve dijital projeler yürüttüklerini belirtti.
Özellikle çocukların ve gençlerin Türkçeyi doğru ve etkili kullanmalarına yönelik faaliyetlere önem verdiklerini kaydetti.
Türk dünyasında ortak alfabe çalışmaları sürüyor
Mert, Türk dünyasında ortak alfabe oluşturulmasına yönelik çalışmalara da değindi.
2024'te Bakü'de 34 harfli çerçeve alfabenin kabul edilerek ilan edildiğini hatırlatan Mert, ilgili ülkelerin akademik kurullarının kendileri için önerilen harfleri 2024'ten bu yana değerlendirdiklerini söyledi.
Kazakistan ve Kırgızistan'ın kullanacağı harflerin 15 Haziran 2026'da Astana'da yapılan toplantıda ilan edildiğini belirten Mert, Özbekistan'daki sürecin de devam ettiğini aktardı.
Mert, Türkiye'nin kullandığı alfabeye ilişkin ise "Türkiye Cumhuriyeti'nin kullandığı alfabede hiçbir değişiklik yok. Buna ihtiyaç da yok." şeklinde konuştu.